Apprendre à enseigner : le nouveau super-pouvoir des IA
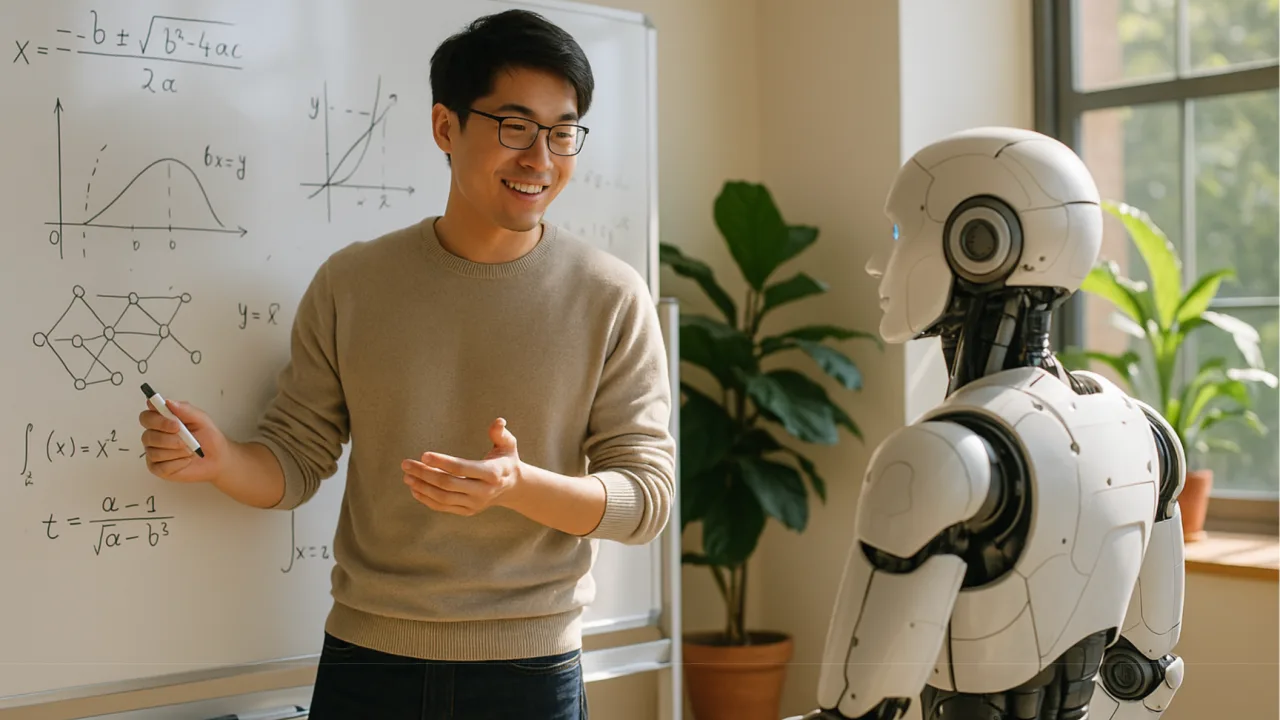
Jusqu’à présent, l’apprentissage par renforcement (RL) visait à entraîner des modèles géants à résoudre des problèmes complexes de manière autonome (DeepSeek R1, QwQ, etc.). C’était coûteux, inefficace en généralisation, et les modèles étaient récompensés uniquement pour la réponse correcte.